Salesforce 给全球 SaaS 公司打了个版:27年软件经验训进 AI,不碰一条客户数据
Salesforce 如何把 27 年 CRM 经验变成 AI 的练习场?从 Koa 到 AIforce,我看到企业软件从教人操作,到训练 AI 替人办事的一次转变。
前两天看 Agent 给我发的商业简报,有一条消息引起了我的兴趣:
Salesforce 发布了一个 CRM 推理模型,叫 Koa,说是把 27 年的 CRM 经验训练进了模型。
我以前做过 SaaS,又是销售背景,对 CRM 这套东西很熟悉,且 Salesforce 是这个领域的绝对头部玩家,很多国内的 CRM 产品都“抄过”它。这两年进入AI时代后,它就鲜少再出现在信息流里,我都快把它忘了。
所以看到 Salesforce 的名字,推理模型,再加上“27 年业务经验”,一下就来了兴趣。
全球最大的 CRM 巨头居然自己下场做推理模型,而且还号称把“27 年经验”装了进去,我的第一反应是:居然做了个模型,而不是Agent? 27 年的业务经验,要怎么“装”进去?
更有意思的是,它明确表示:
整个训练过程,没有使用任何真实的客户数据。
What?!没用客户数据?
那这所谓的“27 年业务经验”,到底是什么?
我就更好奇了,我就顺着消息一路扒下去,越看越兴奋。
因为这背后展示出来的,是企业软件在 AI 时代一次很根本、也很有意思的转变。
先理清一个概念:Koa 是大脑,不是智能体
聊它的机制之前,先理清一个容易混淆的认知。
很多人看新闻摘要,容易误以为 Salesforce 做了个叫 Koa 的智能体(Agent)。
其实不是。
论文标题写得很严谨:
Salesforce Koa: An Enterprise Language Model for Agentic Tool Use。
翻译过来是:
一个专门为了智能体工具调用而生的企业大语言模型。
所以它是一个实打实的、拥有 1200 亿参数的基础大模型。
9 月 15 日,Salesforce 与 NVIDIA 宣布推出 Koa。它在 NVIDIA Nemotron 这个开放权重的底座模型上,做针对企业工作的后训练,得到这个供自家 Agentforce 智能体平台使用的推理模型。
那它和我们平时说的智能体,到底是什么关系?
如果把一个在企业里办事的数字员工做个拆解:
Koa,就是这个员工的大脑。
外面的 Agentforce 平台是它的身体和执行系统;而底层的 CRM 数据库、邮件、各类业务接口,则是它的手和脚。
假设你开了一家公司,平时招普通大模型进来,它就像一个刚入职的名校高材生。
你问它:“这个客户沟通三次了,预算 80 万,合同还没签,我接下来怎么办?”
它能给你写一篇头头是道的宏观分析。
但真实企业要的不是一篇分析,而是要有人去具体办事:
Tasks:
① 找到这个客户的商机记录
② 查看过去三次沟通记录
③ 检查合同审批状态
④ 判断销售阶段应该改成什么
⑤ 更新系统数据
⑥ 创建一个法务跟进待办
⑦ 通知对应的业务负责人
⑧ 三天后如果还没签,自动再提醒一次
这就是 Koa 要干的事。
再举个常见的日常场景。
客户发来一句询问:“为什么我们这个月账单突然多了 20%?”
普通聊天机器人只会去搜帮助文档,写一段客套但解决不了问题的计费说明。
而由 Koa 驱动的系统,大脑里在做连续的业务推演:
第一步:识别客户身份
第二步:调用接口查询账户订阅历史
第三步:比对两个月账单,定位到增加了 25 个账号
第四步:查询权限记录,查清是谁在哪一天审批添加的
第五步:判断账单是否合规
   · 若无误:向客户清楚解释变动明细
   · 若算错:自动创建异常工单,转交财务核对
在这个过程中,Koa 并不直接伸手去数据库改数据。
它只负责两件事:
理解当前的业务状态,决定下一步该调用哪个工具。
真正执行操作的,是外层的运行系统。
Koa,就是 Salesforce 专门给自家系统训练出来的“业务决策大脑”。
好,那么问题来了,宣称没用一条客户数据的 Salesforce,是怎么把 Koa 这个大脑训练出来的?
27年的经验,被做成了 AI 的“练习场”
这 Part 来聊一聊,不用客户数据,Salesforce 凭什么把 27 年经验装进这个大脑?以及装的到底是什么?
答案很意外,是:Workflow Specification(工作规范)。
过去 27 年,Salesforce 最值钱的“遗产”是什么?
根本不是数据库里各家公司的机密流水或者合同数量,而是沉淀下来的业务工作规范:
一个销售线索进来,满足什么条件才能转成商机?
一个售后工单,什么情况下必须升级给主管?
一笔超过 5000 美元的退款,要走哪几层审批?超过 30 天还能不能退?
金融、制造、医疗……不同行业的标准作业流程到底长什么样?
这些规则,过去躺在产品逻辑、数据架构、权限边界和行业解决方案里。
他们干了一件极其聪明的事:
用这套成熟的业务规范,在系统里搭建了一个庞大的“企业经营模拟器”。
Salesforce 针对 14 个行业合成了海量虚拟场景。
然后,他们找来一个辅助大模型,在模拟器里一人分饰三角:
角色一:扮演形形色色、甚至故意挑刺的虚拟客户;
角色二:扮演软件系统,给工具调用返回逼真的模拟数据;
角色三:充当裁判,全程盯梢打分。
他们把 Koa 放进这个虚拟沙盒里,让它去“上班”。
在沙盒里,每一个任务都被定义得极其清晰:
【模拟工作任务】:处理客户退款申请
可用工具:
· 查询客户信息
· 查询历史订单
· 查询退款政策
· 执行退款操作
· 转交人工客服
工作规则:
· 超过 5000 美元必须人工审批
· 购买超过 30 天不能直接退款
· 必须先确认订单的实际状态
成功条件:
· 客户问题合规解决
· 并且没有越权或乱用工具
虚拟客户跑来说:“我两个月前买的软件不好用,现在要退款!”
Koa 就得自己在沙盒里查客户 → 查订单 → 发现已经买了 63 天 → 查退款规则 → 超过期限,不能直接退款 → 向客户说明,必要时转人工。
这时候,如果顺着客户说一句“好的,已经退了”,服务态度看着挺好,工作可没做对。
一个场景,Koa 可以在模拟器里翻来覆去跑成千上万次。
真正的训练资产,不是数据库里的静态死数据,而是把工作经验变成了源源不断生成训练场景的“企业模拟器”。
在具体的训练机制上,Salesforce 还发现了一个关键点:
面对复杂的多轮工具调用,传统的 SFT 监督微调(让模型背题库)几乎没有什么用。
因为真实业务从来没有唯一标准答案。面对投诉客户,有人先看沟通历史,有人先查订单,如果强迫模型死记硬背一套固定步骤,现实中只要情况稍微变化,模型立刻就会卡壳死循环。
所以他们把重心全押在了强化学习上。
裁判要看整个处理过程。涉及具体业务数据的问题,有没有调用相关工具拿到依据?客户提出的问题,究竟哪些已经解决?
事情办成了、没踩红线 → 给奖励;
没办成,或者乱调工具 → 扣分;
如果连续重复同一个工具调用,这轮奖励还会直接归零。
这些工作过程和反馈,被用来调整模型的参数。这就是强化学习在这里的用法。同一类任务可以反复练,让它在不同情况里尝试,逐渐提高得分。
Salesforce 还会故意把能办事的工具拿掉,看模型会怎么办。遇到做不了的事,要说清楚缺什么,或者交给人,不能假装已经办完。
会干活,也得知道什么时候不能瞎干。
到这里,我才看懂了这“27 年经验”到底是什么样子。
一个做了27年 CRM 软件的公司,最知道销售线索怎么判断、工单怎么流转、哪些动作需要审批。这些积累让它能定义清楚工作规则,构造练习场景,也知道怎样检查结果。模拟过程中产生的对话、动作和反馈,才进一步用于训练。
原来软件里沉淀的工作方法,还能拿来给 AI 出题。
Koa 的模型跑分肯定跑不过当前的那几个顶尖梯队的模型,但 Salesforce 根本没想去跟通用模型拼写诗和写代码。
它要的是:在企业日常最核心的几千个业务动作里,足够可控、便宜,而且模型牢牢握在自己手里。
老 SaaS 的痛点:企业买得起软件,跨不过门槛
看到这里,我挺感慨的。
我以前做过 SaaS,还是销售背景出来,平心而论,过去三十年 SaaS 软件的兴起,是一次巨大的商业进步。
它把原本散落在各个销售脑子里、甚至小笔记本上的客户信息,变成了标准化的流程。销售线索怎么跟进、商机阶段怎么推进、审批怎么流转,都被搬上了云端。业务流程被规范了,信息可以共享,团队协作也更顺畅了。
但与此同时,另一个无法回避的现实摩擦也出现了,我觉得做过 SaaS 的朋友可能都有过相同的痛点:
企业把软件买回去了,员工真的用得起来吗?
未必。
为什么?
因为任何软件都有使用门槛,需要人先学怎么操作,然后才是用。很多企业和销售团队不是没有管理意识和协同意识,而是在第一步就被卡住了,这点在国内市场尤其明显。
一个优秀的销售,核心竞争力本该是去理解客户、捕捉需求、建立信任。
但为了让系统运转起来,他每天还要花大量的时间和精力去适应软件,比如,这个信息填在哪个字段?商机阶段该怎么改?审批流走到哪一步了?下一步该点哪个菜单?
很多时候,员工为了完成一件事,不得不先把自己训练成一个熟练的“软件操作员”。
这也就是为什么在企业软件领域,会衍生出那么庞大的实施顾问、培训团队,以及有些大公司还有一个专职的岗位名称叫客户成功(Customer Success)团队。
企业买 CRM,真正想要的是把销售管理做好、把业务跑通,而不是得到一本几百页的软件操作手册,花3个月先熟悉软件。
但过去,卖软件和用好软件之间,隔着一条巨大的鸿沟。软件公司只能靠大批客户成功或实施人员人肉驻场,手把手教客户怎么配置、怎么操作、怎么把自己的业务嵌进系统里。
本质上,大家都在靠人力服务,去填补“业务意图”与“软件操作”之间的缝隙。
这就引出了一个我们习以为常、却很少深思的问题:
为什么一定要人先学会软件,工作才能往下走?
底层的范式反转:从“人学软件”,到“软件教 AI 怎么干活”
所以,Koa 让我觉得最受启发的地方,恰恰是它打破了这个惯性。
把两件事情放在一起看,结构上的反转非常清晰:
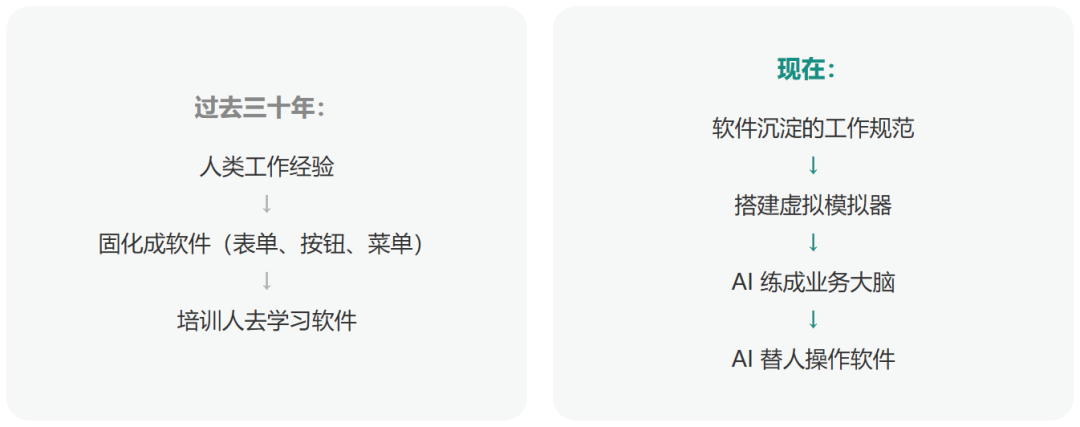
这是一个很根本的反转。
曾经需要顾问坐在旁边教、员工一遍遍学的那些操作经验——这个工单应该分派给谁?这个商机缺少了什么关键信息?这个退款应该调哪几个底层接口核验?
现在,这些能力正在被压缩进模型的权重里。
软件正在从 Software you learn to use(你必须学习使用的软件),
变成 Software that knows how to use itself(自己知道该怎么使用自己的软件)。
你不再需要去研究二级菜单里的按钮叫什么名字,不再需要记得转商机要在哪里提交登记。
你只需要像跟资深业务助理说话一样,表达你的业务目标:
“帮我查一下上个月掉单但有挽回希望的客户,找出原因,安全的跟进动作直接安排掉,需要我确认的列出来。”
剩下的查表、比对、关联对象、跑工单、发通知,全由模型在后台默默完成。
当学习和操作软件的门槛被模型内部消化掉,人与工具之间的那层摩擦,第一次被大幅缩窄了。
软件不会消失,但人与软件的关系要变了
顺着这个逻辑再往前推一步:如果软件越来越多地由智能体来操作,那我们熟悉的 SaaS 会消失吗?
我倒不觉得软件会完全消失,只是会逐渐的不再被人看见。
就在发布 Koa 的第二天,Salesforce 紧跟着发布了另一个产品动作:AIforce。
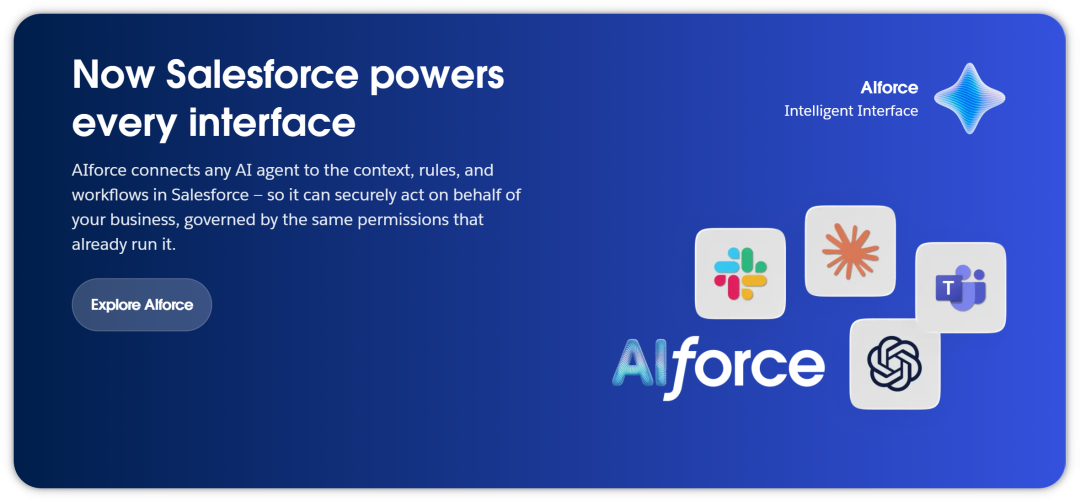
官方直接用了一个词:Headless。
大白话讲,就是把“脸”拿掉。
(“脸”在这里指代给人看的UI界面。)
那个我们过去三十年习以为常的软件形象——复杂的菜单、一排排表格、花哨的数据大盘、必须登录进去才能点击的网页,正在退居二线。
Salesforce 甚至在宣传里直说:未来员工可能几个月都不需要登录一次 Salesforce,你在 Slack、在 Claude、在任何常用的对话框里,就能直接调用它的能力。
但这绝不代表软件死了。相反,它把软件清晰地切成了两层:
一层是:核心记录系统(System of Record)
客户档案、资金流水、权限边界、合规审计。这些核心资产不仅不会消失,反而会成为智能体在真实世界行动时唯一信赖的现实锚点。
另一层是:能力暴露层(Capability Layer)
软件公司不再只卖静态页面,而是通过 MCP、API、plugins、skills 把 Salesforce 的数据、Workflow、业务逻辑、权限和动作暴露出去。
软件脱掉了给人类点击的外衣,退到了后台,变成企业运转的底层能力基座。
以后看一家软件公司,光看它有多少功能、多少页面,可能越来越不够了。更值得看的是,它对业务的理解,能不能真正帮助 Agent 把工作完成。
软件里的规则、权限、工具和成功标准,原来藏在界面后面的这些东西,会变得更值得研究。
过去,我们把工作经验做成软件,再教人使用;
现在,我们用这些经验训练 AI,让它替人去操作软件。
软件没有消失,但人与软件之间的关系,彻底变了。
我觉得其实大家期待的,从来不是什么“以后再也不用工作了”,而是我们终于能把更多心思放在事情本身,少一点花在研究工具怎么用上。
客户关系怎么经营,生意该怎么做,如何理解真实的人和需求——这些充满温度与商业判断的事情,值得人认真想。
至于信息该填进哪个框、下一步该点哪个按钮,就让工具多操点心吧。